Aller au contenu principal

Applications Web et logiciels

Un modèle pratique d’état, d’alerte et de responsabilité pour les tableaux de bord

Concevez des alertes avec des conditions explicites, un niveau de gravité, un accusé de prise en charge, une attribution, une escalade et un historique de résolution.

Par Sunbot Labs

Mis à jour le

4 min de lecture

Une alerte opérationnelle passant de la détection à la responsabilité, à l'enquête, à l'escalade, à la résolution et à la réouverture.

Comment le flux de travail s’articule

  1. 1Détecter et classer l'état
  2. 2Créer ou mettre à jour un dossier d’alerte
  3. 3Attribuer l’alerte et en accuser la prise en charge
  4. 4Escalader lorsque les délais de réponse ne sont pas respectés
  5. 5Résoudre avec des preuves et conserver l’historique

Les tableaux de bord utilisent souvent des badges rouges pour signaler les problèmes sans définir qui doit répondre ou comment l’alerte est levée. Le fait de traiter chaque alerte comme un dossier de flux de travail crée un chemin responsable depuis la détection jusqu'à la prise en charge, l’analyse et la résolution.

Définir la condition et sa règle de retour à la normale

Indiquer la mesure de la source ou l'événement, le seuil, la durée, la clé de regroupement et la condition qui renvoie l'alerte à la normale. Un seul travail tardif peut créer une tâche, tandis que des échecs répétés pour la même intégration peuvent appartenir à un incident. Ces règles empêchent les alertes en double bruit.

Gravité, priorité et statut distincts

La gravité décrit les conséquences, la priorité décrit l'ordre de réponse et l'état d'avancement. Un problème de haute gravité peut déjà être contrôlé, tandis qu'un problème de faible gravité affectant un client sensible au temps peut rester la prochaine action. Garder ces champs séparés rend le tri et l'escalade plus honnête.

Utiliser un cycle de vie de responsabilité explicite

Un cycle de vie utile comprend un nouveau, reconnu, enquête, attente, résolu et rouvert. Enregistrez la personne ou l'équipe assignée, l'heure de reconnaissance, la prochaine vérification et les notes. La réaffectation devrait préserver l'histoire plutôt que de remplacer silencieusement le propriétaire original.

  • État et dossiers touchés
  • Propriétaire actuel et cible de réponse
  • Remerciements et notes d'enquête
  • Événements d'escalade
  • Preuve de résolution et raison de réouverture

Concevoir une politique de notification et de responsabilité

Prévenez le plus petit groupe capable d'agir, puis augmentez par le temps et la gravité. Évitez d'envoyer chaque changement d'état à chaque gestionnaire. Les tableaux de bord doivent montrer des alertes muettes, reconnues et en attente, de sorte que le silence n'est pas confondu avec la résolution.

Suivre une alerte de la détection à la fermeture

Une intégration n'a pas traité une mise à jour client dans sa fenêtre normale. Le système crée une alerte liée à la connexion et aux enregistrements touchés, l'attribue à la file d'attente d'intégration, et marque sa gravité par suite des conséquences commerciales plutôt que du nombre de tentatives ratées. Les vérifications répétées mettent à jour la même alerte au lieu d'envoyer un nouveau message chaque minute.

Un opérateur accepte la responsabilité, examine le dernier point de contrôle et d'erreur réussi, et choisit une réessayer en toute sécurité. Après le traitement reprend, le rapprochement confirme que les dossiers touchés correspondent. Ce n'est qu'alors que l'alerte se déplace pour être résolue. L'histoire conserve la détection, la reconnaissance, les actions, les preuves de rétablissement et la fermeture.

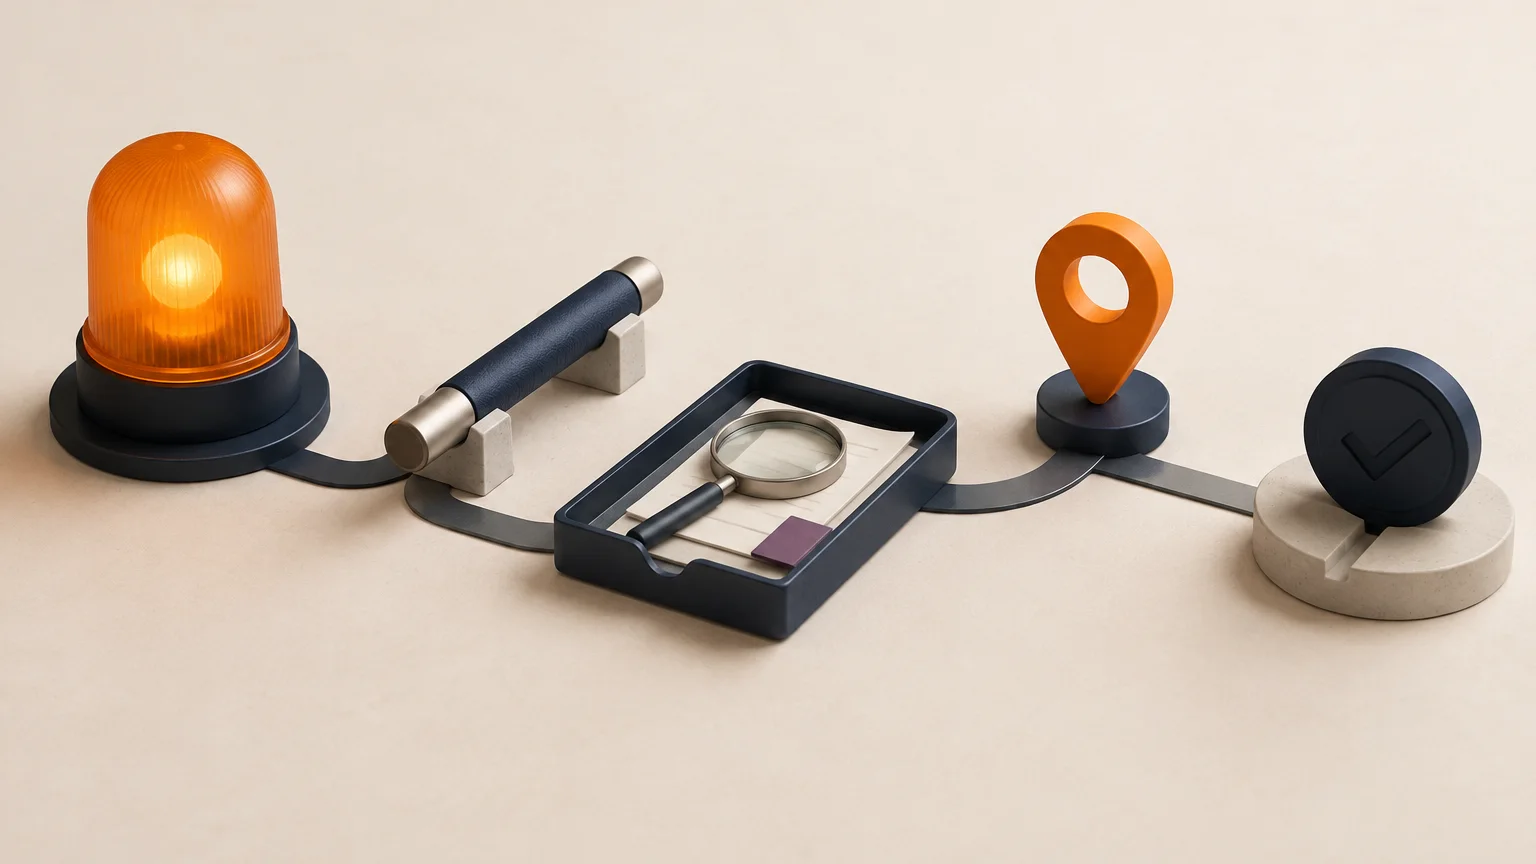
Un retard d'intégration devient une alerte groupée avec la gravité de l'entreprise, les dossiers touchés et un propriétaire responsable.

Repère visuel

Un cycle de vie d'alerte avec une responsabilité explicite

Le statut décrit l'état de fonctionnement de l'alerte, tandis que la gravité et la priorité répondent à des questions distinctes.

  1. 1

    Ouvrir

    La condition est active et n'a pas été acceptée par un propriétaire.

  2. 2

    Remerciements

    Une personne ou une équipe a vu l'alerte et possède la réponse.

  3. 3

    Enquêtes

    Les preuves et les dossiers touchés sont à l'étude.

  4. 4

    Migrés

    L'impact immédiat est maîtrisé alors que le rétablissement complet est en cours.

  5. 5

    Résolue

    L'état de compensation et les contrôles de récupération sont passés.

  6. 6

    Réouverture

    La condition retournée ou la vérification a échoué.

La reconnaissance arrête la responsabilité dupliquée; la résolution attend une règle de compensation définie.

Faire correspondre les notifications à l’urgence et aux heures d’exploitation

Choisissez les canaux à partir de la gravité, des heures d'exploitation et de la réponse attendue. Un problème de qualité des données à faible impact peut entrer dans une file d'attente quotidienne, tandis qu'une panne de production affectant le travail actif du client peut pager le propriétaire sur appel. L'escalation devrait changer de destinataire ou d'autorité après un délai déterminé; répéter la même notification n'est pas une escalade.

Examiner les alertes bruyantes, les alertes non reçues, les changements de sévérité manuelle, le temps de reconnaissance, le temps de récupération et les incidents rouverts. Supprimer les alertes qui ne conduisent pas à une décision, ou les convertir en signaux de tableau de bord informationnel. Préservez les fenêtres d'entretien et les raisons de suppression afin que le silence soit délibéré et visible plutôt que accidentel.

  • Définir la condition et la règle de compensation séparée
  • Définir la gravité de la conséquence et la priorité de l'ordre de réponse
  • Nommer le propriétaire d'acceptation et le chemin d'escalade
  • Grouper les observations répétées en un seul incident, le cas échéant
  • Exiger des preuves de récupération avant la fermeture
La notification, l'accusé de réception, l'escalade, la suppression de l'entretien et les preuves de recouvrement sont conformes à la responsabilité.

Questions pratiques

Questions fréquentes sur le sujet

Les alertes doivent-elles se fermer automatiquement?

Les conditions techniques peuvent être automatiquement claires lorsque la règle de compensation est fiable. Les alertes d'impact sur les entreprises peuvent encore nécessiter une confirmation ou une note de résolution avant la clôture.

Quelle est la différence entre mute et reconnaissance?

La reconnaissance signifie que une personne est responsable de l’intervention. Le changement modifie le comportement de notification pour une période ou une raison définie et devrait demeurer visible dans le dossier d'alerte.

Collaborer avec Sun Cluster

Vous planifiez un système semblable pour votre organisation?

Sun Cluster construit des tableaux de bord internes avec des états opérationnels clairs, la responsabilité d'alerte, des exercices de exploration détaillée et des flux de travail connectés.