Aller au contenu principal

Systèmes de négociation

Concevoir les alertes, les limites et la récupération d’une automatisation crypto

Coordonnez les limites logicielles, l’état de la plateforme, les alertes, les modes dégradés et le rapprochement avant de reprendre l’automatisation.

Par Sunbot Labs

Mis à jour le

5 min de lecture

Automatisation de cryptographie multi-échange à l'aide d'alertes de component-ware, de limites explicites, de rapprochement et de récupération contrôlée.

Comment le flux de travail s’articule

  1. 1Détecter une limite ou une dégradation
  2. 2Bloquer toute nouvelle action touchée
  3. 3Créer un incident distinct
  4. 4Interroger l’état faisant autorité de la plateforme
  5. 5Reprendre sous surveillance

Les plateformes de cryptoactifs fonctionnent en continu, mais un système d'automatisation nécessite toujours des conditions d'exploitation limitées. Les limites de taux, les flux de données interrompus, les ordres rejetés, les changements d’identifiants, les fenêtres de maintenance et les écarts de flux devraient déplacer le système dans des états explicitement dégradés ou interrompus avec un processus de récupération contrôlé.

Séparer les limites configurées des contraintes de la plateforme

Les limites logicielles définies par le client peuvent restreindre les instruments, la taille des demandes, la fréquence des commandes ou l'exposition globale. Les contraintes d'emplacement comprennent la précision, les minimums, les autorisations et les limites de taux. Consigner la couche qui a empêché une action et préserver le contexte de la demande sans réessayer un rejet de politique.

Modéliser le fonctionnement dégradé par composant

Un flux de marché public peut échouer pendant que les mises à jour d'ordre privé restent connectées. Un échange peut être indisponible alors qu'un autre est sain. Suivre l'état du composant et définir les stratégies ou les actions qui dépendent de chaque composant plutôt que de présenter un indicateur global vert ou rouge.

  • La fraîcheur des données du marché
  • État du flux de compte privé
  • REST demande santé et budget de limite de taux
  • Synchronisation de l'horloge
  • Titre de créance et statut de permission

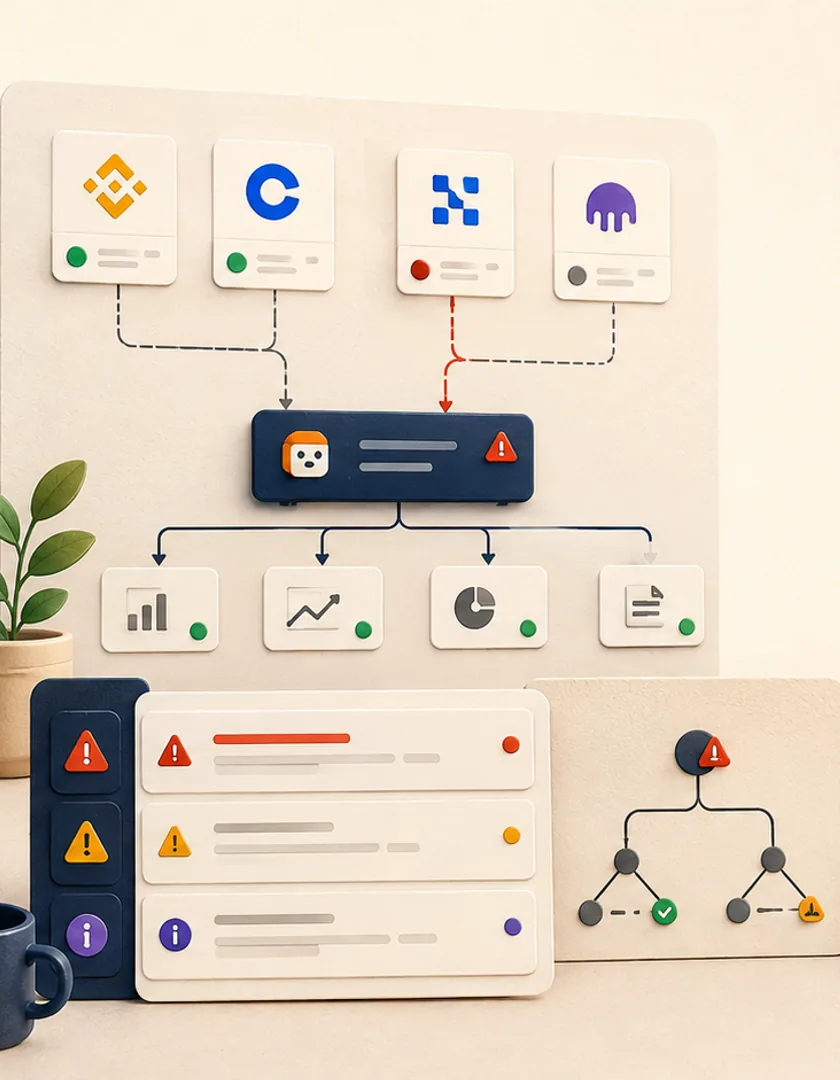
Transformer les alertes en incidents et non en tempêtes de messages

Grouper les détections répétées par plateforme, connexion et état. Créer un incident avec premier et dernier événement, flux de travail touchés, propriétaire actuel, reconnaissance et temps d'escalade. Mettre à jour comme preuve change plutôt que d'envoyer une notification séparée pour chaque tentative de reconnect.

Exiger un rapprochement avant la récupération

Après un manque de soumission ou de connexion incertain, récupérer les ordres, les exécutions, les soldes et les positions actuels appuyés par le lieu. Comparez-les avec les enregistrements locaux, corrigez les écarts, confirmez les nouvelles données et les autorisations saines, puis demandez un retour par le garde de transition normal.

Distinguer la défaillance d’un composant de la réponse du système

Si un flux de données du marché d'échange devient inexistant, la stratégie ou l'instrument concerné devra peut-être cesser de créer de nouvelles demandes pendant que la surveillance des comptes et des commandes se poursuivra. Un deuxième échange sain ne rend pas la première connexion saine, et un arrêt global peut être inutile si le modèle d’exploitation permet la dégradation isolée.

Définir l'état de détection, la portée affectée, l'action de protection automatique, le propriétaire de l'alerte, le temps d'escalade et le test de compensation pour chaque défaillance. Les limites doivent indiquer si elles s'appliquent par demande, stratégie, compte, instrument, lieu ou fenêtre temporelle. Le tableau de bord doit montrer la valeur configurée et l'observation qui l'a traversée.

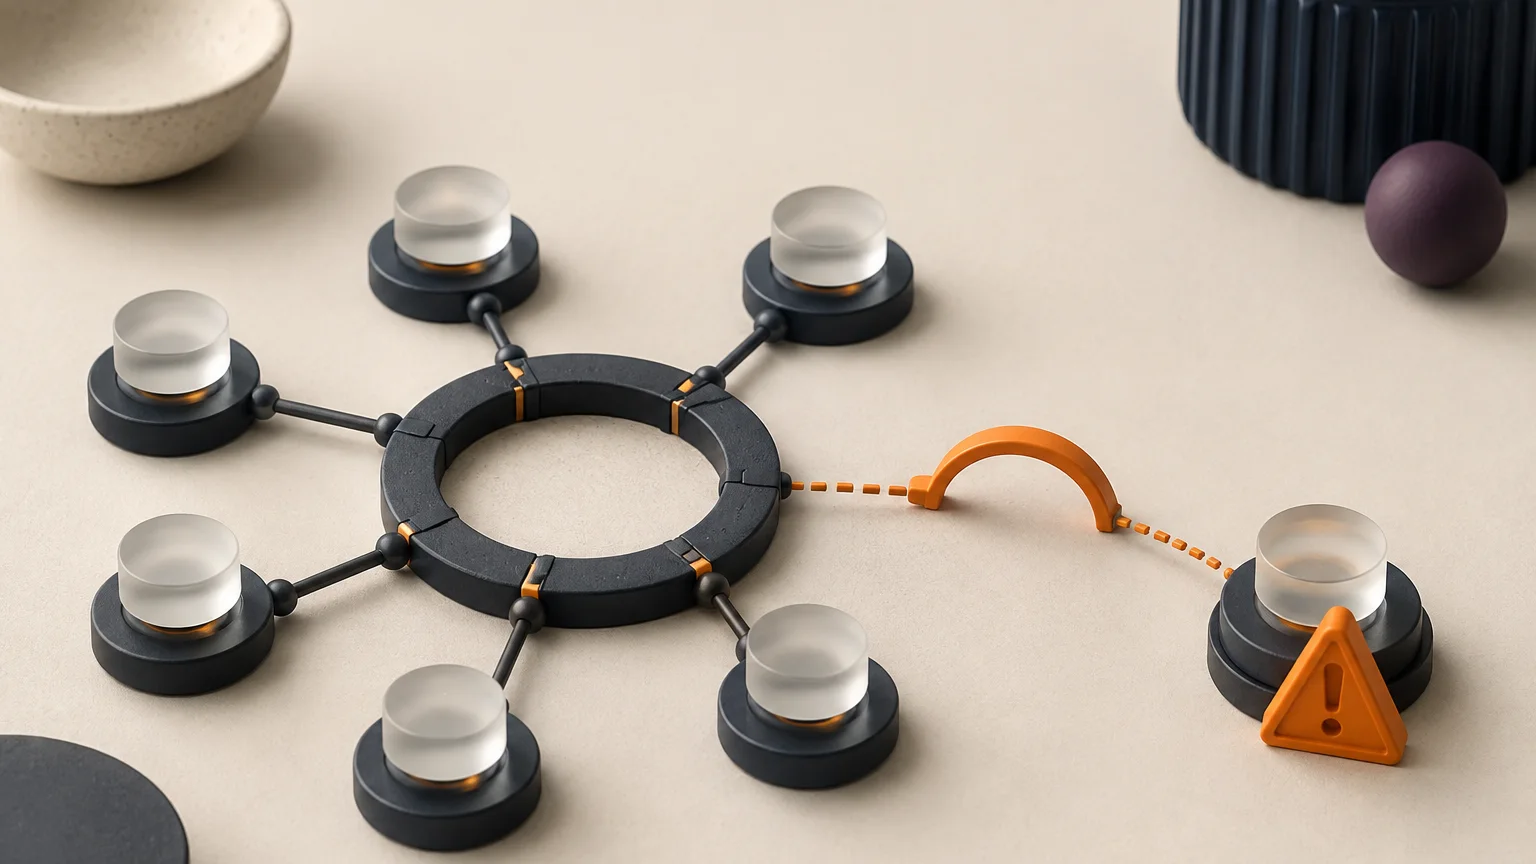
Une connexion d'échange dégradée isolée de composants sains avec des preuves d'alerte groupées.

Repère visuel

De l'état détecté à la récupération contrôlée

Une alerte est utile lorsqu'elle identifie la portée, les mesures de protection, le propriétaire et les éléments de preuve à reprendre.

  1. 1

    Détecter

    Observez les données inexistantes, les demandes rejetées, la déconnexion ou la limite du logiciel.

  2. 2

    Contient

    Éliminer la portée touchée et préserver la surveillance autorisée.

  3. 3

    Avis

    Créer un incident dont la gravité dépend des conséquences.

  4. 4

    Enquête

    Examiner la connexion, les événements, les commandes ouvertes et l'état local.

  5. 5

    rapprochement

    Comparer les faits de la plateforme avant de dissiper l'incertitude.

  6. 6

    Récupérer

    Reprendre par l'entremise de gardes autorisés et consigner le résultat.

Les logiciels de protection limitent l'exploitation contrôlée; ils ne suppriment pas les risques commerciaux ou financiers.

Exécuter des exercices de récupération avant qu'ils ne soient nécessaires

Tester un flux abandonné, un titre expiré, une limite tarifaire, une panne partielle, un événement de commande retardée, une soumission incertaine et un redémarrage du service avec une commande ouverte. Confirmer quels flux de travail s'arrêtent automatiquement, ce qui reste visible, qui reçoit l'alerte et si une personne peut déterminer la prochaine action sécuritaire à partir de la preuve conservée.

Un bouton de reprise devrait revérifier les conditions de compensation d'origine. La fermeture d'un signalement ne doit pas automatiquement permettre la soumission. Examiner les tempêtes d'alerte, les dépassements manuels répétés, les longs temps de rapprochement et les incidents qui rouvrent peu après le rétablissement. Ces tendances révèlent des seuils faibles, un état manquant ou une responsabilité opérationnelle qui n'a pas été attribuée.

  • Utiliser des conditions de bac à sable, de démonstration ou d'essai contrôlé, le cas échéant
  • Consigner les éléments attendus et les états généraux du système
  • Vérifier les notifications sans exposer les secrets ou les données de compte
  • Confirmer le rapprochement de l'ordre ouvert et de la position après le redémarrage
  • Maintenir les décisions de recouvrement séparément des décisions de stratégie de négociation
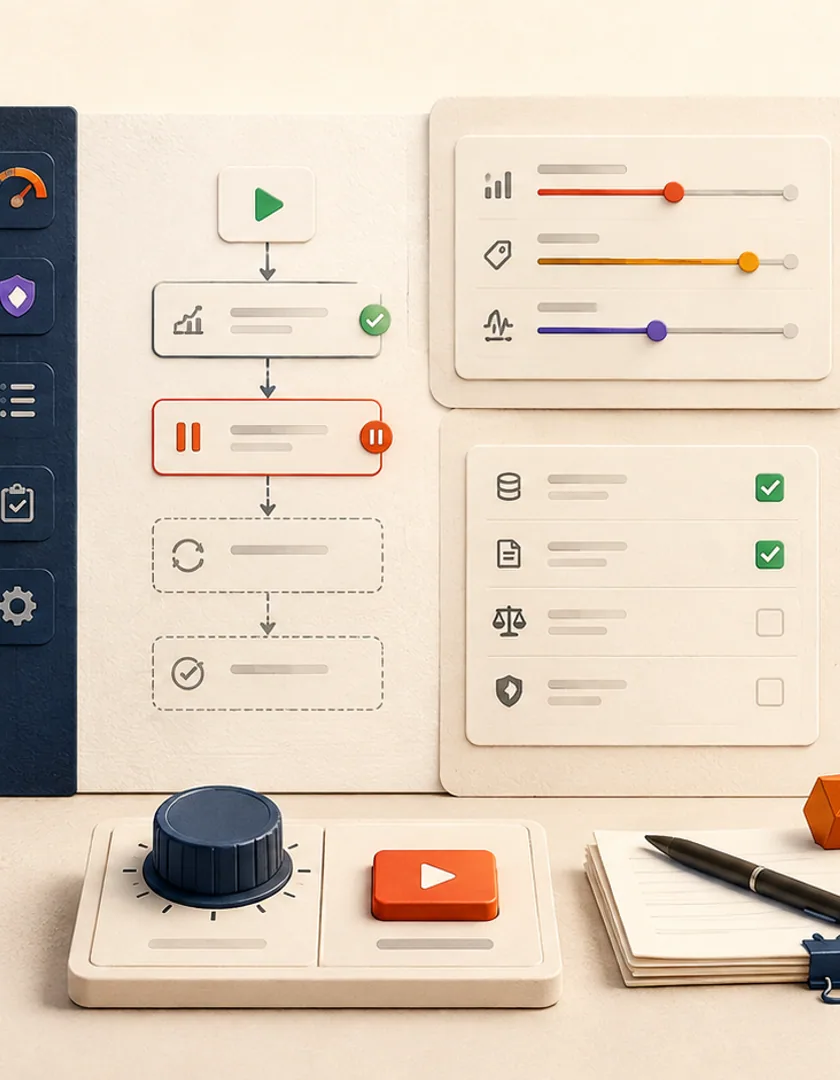
Un flux de travail interrompu passant par des vérifications de rapprochement et de récupération avant un CV autorisé.

Questions pratiques

Questions fréquentes sur le sujet

L'automatisation devrait-elle annuler les commandes lorsqu'un flux de données devient inexistant?

C'est une politique opérationnelle définie par le client. Le logiciel devrait empêcher les nouvelles décisions dangereuses, faire ressortir les ordres touchés, et effectuer l'annulation seulement lorsque explicitement spécifié et autorisé.

Peut-on reconnecter le succès automatiquement fermer un incident?

Une connexion peut récupérer pendant que l'ordre manqué ou les mises à jour de compte restent. Fermez seulement après la vérification de la santé et du rapprochement.

Collaborer avec Sun Cluster

Vous planifiez un système semblable pour votre organisation?

Sun Cluster construit une automatisation crypto privée avec des intégrations d'échange, des limites définies par le client, des alertes opérationnelles et des flux de travail de récupération.